Jak reportovat SEM fit indices: CFI, RMSEA, SRMR

Tato stránka je překladem recenzovaného anglického originálu. Zobrazit originál (EN)
reporting SEM fit indicesAndrzej Szymkowiak · Naposledy zkontrolováno v červenci 2026
Recenzent vás právě požádal, abyste obhájili fit svého modelu. Tady je přesně to, co reportovat. Poté, co spustíte structural equation model (SEM) nebo confirmatory factor analysis (CFA), je první otázka, kterou recenzent položí: pasuje model na data? Na to odpovídáte pomocí fit indices. Tento průvodce vysvětluje hlavní indexy, cutoffy, které recenzenti očekávají, a jak je napsat ve stylu APA. Cílem je jedna čistá tabulka a několik správných vět.
Proč reportujete několik indexů
Fit modelu není jedno číslo. Každý index se dívá na fit z trochu jiného úhlu, takže reportujete malou sadu pohromadě. Reportovat jen jeden index — zvláště chi-square test — nestačí. Běžnou, dobře citovanou sadou je: χ², CFI, TLI, RMSEA a SRMR (Hu & Bentler, 1999).
Chi-square test (a jeho problém)
χ² test hodnotí nulovou hypotézu, že kovarianční matice implikovaná vaším modelem se rovná populační kovarianční matici. Nesignifikantní χ² je v souladu s dobrým fitem, ale nedokazuje model: neodmítnutí nuly není totéž co její potvrzení. Problém: χ² je velmi citlivý na velikost vzorku. S velkým vzorkem je χ² téměř vždy signifikantní, i pro dobrý model. Takže ho reportujete pro úplnost, ale neodmítáte model na základě χ² samotného. Reportujte hodnotu, stupně volnosti a p hodnotu:
χ²(98) = 142.31, p = .002
Inkrementální indexy: CFI a TLI
CFI (comparative fit index) a TLI (Tucker-Lewis index) porovnávají váš model s baseline modelem, ve kterém jsou všechny proměnné nezávislé. Vyšší je lepší. CFI je ohraničen mezi 0 a 1, zatímco TLI není normovaný — může příležitostně překročit 1 nebo klesnout pod 0.
- CFI ≥ .95 = dobrý fit; ≥ .90 = přijatelný fit.
- TLI ≥ .95 = dobrý fit; ≥ .90 = přijatelný fit.
Absolutní indexy: RMSEA a SRMR
RMSEA (root mean square error of approximation) a SRMR (standardized root mean square residual) měří, jak daleko je váš model od dokonalého fitu. Nižší je lepší.
- RMSEA ≤ .06 = dobrý fit; ≤ .08 = přijatelný fit. Vždy reportujte 90% confidence interval pro RMSEA.
- SRMR ≤ .08 = dobrý fit.
Cutoffy v jedné tabulce
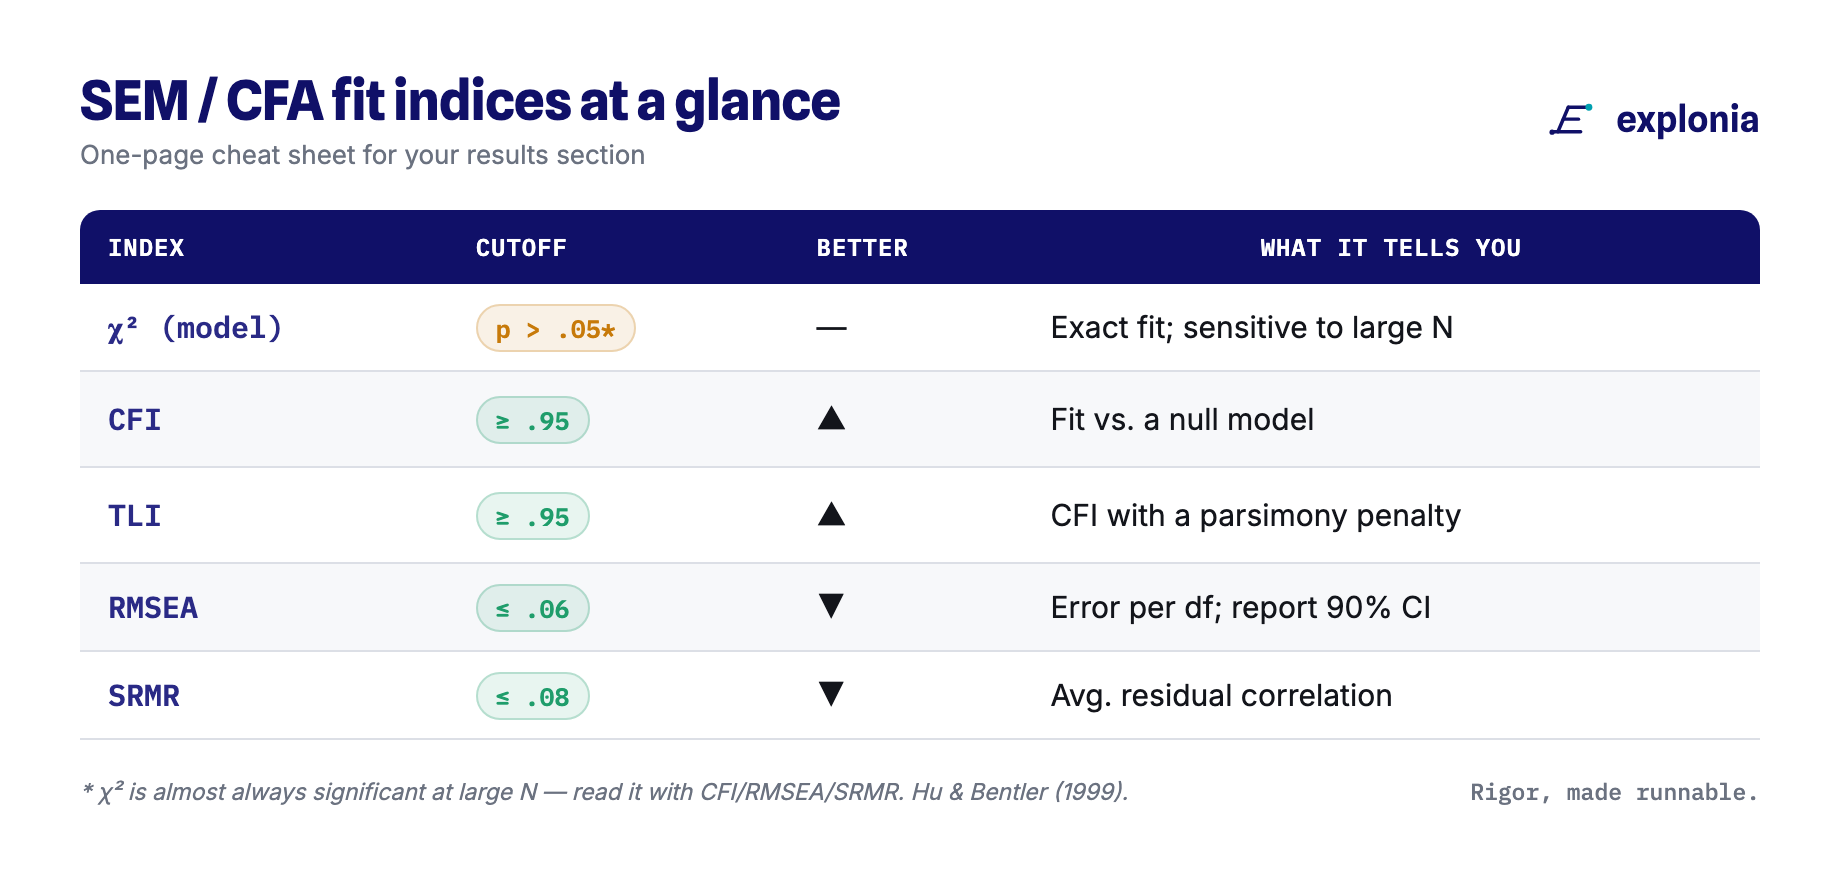
| Index | Dobrý fit | Přijatelný fit | Poznámky |
|---|---|---|---|
| χ² | nesignifikantní | — | citlivý na velké N; reportujte, ale nespoléhejte se příliš |
| CFI | ≥ .95 | ≥ .90 | vyšší je lepší |
| TLI | ≥ .95 | ≥ .90 | vyšší je lepší |
| RMSEA | ≤ .06 | ≤ .08 | reportujte 90% CI |
| SRMR | ≤ .08 | — | nižší je lepší |
Rozdělte atribuci: přísnější prahové hodnoty „dobrého fitu" pocházejí od Hu a Bentlera (1999), zatímco práh „přijatelné" shody .90 sahá k dřívější práci — Bentler a Bonett (1980) jej navrhli pro NFI a TLI (tehdy nazývaný NNFI), a později byl přenesen na CFI (Bentler, 1990) — a RMSEA ≤ .08 odráží samostatnou dřívější konvenci (Browne & Cudeck, 1993). Berte je jako vodítka, ne jako tvrdé hranice prošel/neprošel. Hu a Bentler (1999) také doporučují společné kritérium spíše než čtení jakéhokoli jednotlivého indexu samostatně — například SRMR ≤ .08 spolu s CFI ≥ .95. Posuzujte fit napříč celou sadou indexů a zohledněte velikost svého vzorku a složitost modelu (pokud jste stále ve fázi návrhu, viz velikost vzorku před sběrem dat pro vodítka k volbě adekvátního N). Cutoffy byly odvozeny za specifických simulačních podmínek, takže je příliš nezobecňujte: mohou se chovat odlišně u malých vzorků, složitých modelů nebo různých estimátorů a model, který jen těsně mine jednu hodnotu, není automaticky „špatný" (Marsh, Hau, & Wen, 2004).
Pravidla formátování v APA
- Reportujte χ² s jeho stupni volnosti v závorkách a p hodnotu: χ²(df) = hodnota, p = …
- Použijte žádnou úvodní nulu u indexů, které nemohou překročit 1: CFI = .97 (ne 0.97). Totéž platí pro TLI, RMSEA, SRMR.
- Uveďte RMSEA confidence interval v hranatých závorkách: RMSEA = .038, 90% CI [.023, .051].
- Kurzívou pište statistické symboly tam, kde to APA očekává (například p).
Řešený příklad
Spustíte strukturní model s N = 320. Výstup dá χ²(98) = 142.31, p = .002, CFI = .97, TLI = .96, RMSEA = .038 s 90% CI [.023, .051] a SRMR = .041. Zkontrolujte každý oproti tabulce: CFI a TLI jsou nad .95, RMSEA je pod .06 a SRMR je pod .08. Všechny indexy ukazují na dobrý fit, i když je χ² signifikantní — což je při této velikosti vzorku očekávané. Vaše APA věta:
Strukturní model vykázal dobrý fit na data, χ²(98) = 142.31, p = .002, CFI = .97, TLI = .96, RMSEA = .038, 90% CI [.023, .051], SRMR = .041.
CFA fit před SEM fit
Je dobrou praxí potvrdit měřicí model dříve, než důvěřujete strukturnímu modelu. Ve dvoukrokovém přístupu nejprve spustíte CFA, abyste zkontrolovali, že vaše položky nasycují správné faktory a že je fit dobrý, pak přidáte strukturní cesty a spustíte SEM. Pokud je CFA fit slabý, strukturní výsledky stojí na vratkém základě, takže nejprve opravte měřicí model. Reportujte oba: CFA fit ukazuje, že vaše konstrukty jsou dobře změřené, a SEM fit ukazuje, že path model drží. Stejné indexy a cutoffy platí pro oba kroky, a proto funguje jediný formát fit tabulky napříč celým procesem. Pro plný zápis na straně měření viz jak reportovat výsledky CFA v APA a zkontrolujte odlišnost konstruktů pomocí HTMT vs Fornell-Larcker (Henseler, Ringle, & Sarstedt, 2015). Pokud spouštíte své modely v R, viz jak se Explonia srovnává s lavaanem pro srovnání workflow a formátu výstupu.
Časté chyby, kterých se vyvarujte
- Reportování jen χ² a odmítnutí dobrého modelu, protože χ² je signifikantní při velkém N.
- Čtení jednoho indexu izolovaně místo společného kritéria Hu a Bentlera (např. SRMR ≤ .08 A ZÁROVEŇ CFI ≥ .95).
- Vynechání RMSEA 90% confidence intervalu.
- Přidání úvodní nuly k fit indexům (pište .97, ne 0.97).
- Míchání robustních (MLR) a nerobustních indexů ve stejné tabulce.
Poznámka k robustnímu odhadu
Pokud vaše data nejsou normálně rozdělená a použili jste robustní maximum likelihood (MLR), reportujte škálované (robustní) fit indices a škálovaný χ². Nemíchejte robustní a nerobustní čísla ve stejné tabulce. Uveďte, který estimátor jste použili, aby čtenář mohl hodnoty správně interpretovat.
Co když fit není dobrý?
Pokud několik indexů mine cutoffy, jen tak nemažte položky, dokud čísla nevypadají lépe. Hledejte teoreticky podložené důvody: chybně specifikovanou cestu, položky nasycující špatný faktor nebo konstrukt, který potřebuje dvě dimenze místo jedné. Modification indices mohou navrhnout změny, ale aplikujte je pouze tehdy, když dávají teoretický smysl, a každou změnu, kterou uděláte, reportujte.
Často kladené otázky
Jaká je dobrá hodnota RMSEA?
RMSEA ≤ .06 indikuje dobrý fit (Hu & Bentler, 1999); hranice ≤ .08 pro „přijatelný" fit pochází ze starší konvence (Browne & Cudeck, 1993). Vždy reportujte 90% confidence interval, protože bodový odhad samotný může skrýt nejistotu — široký interval, který sahá nad .08, je slabší než úzký, který zůstává pod .06.
Proč je můj chi-square signifikantní?
χ² je velmi citlivý na velikost vzorku. S velkým N i dobře fitující model obvykle produkuje signifikantní χ². Proto reportujete χ² pro úplnost, ale fit posuzujete podle celé sady indexů (CFI, TLI, RMSEA, SRMR), ne podle χ² samotného.
Které fit indices mám reportovat?
Reportujte χ² s jeho stupni volnosti a p hodnotou, plus CFI, TLI, RMSEA (s jeho 90% confidence intervalem) a SRMR. Tato sada pokrývá inkrementální i absolutní fit a je tím, co většina recenzentů očekává (Hu & Bentler, 1999).
Reportuji různé indexy pro CFA a SEM?
Ne. Stejné indexy a cutoffy platí pro oba. Nejprve potvrďte CFA (měřicí model) fit, pak reportujte SEM (strukturní model) fit pomocí stejného formátu tabulky.
Může Explonia vytvořit moji fit tabulku?
Ano. Explonia vrací χ², CFI, TLI, RMSEA s jeho 90% confidence intervalem a SRMR v jedné tabulce a navrhne APA fit větu s vašimi čísly, kterou pak upravíte.
References
Bentler, P. M. (1990). Comparative fit indexes in structural models. Psychological Bulletin, 107(2), 238–246. https://doi.org/10.1037/0033-2909.107.2.238
Bentler, P. M., & Bonett, D. G. (1980). Significance tests and goodness of fit in the analysis of covariance structures. Psychological Bulletin, 88(3), 588–606. https://doi.org/10.1037/0033-2909.88.3.588
Browne, M. W., & Cudeck, R. (1993). Alternative ways of assessing model fit. In K. A. Bollen & J. S. Long (Eds.), Testing structural equation models (pp. 136–162). Sage.
Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8
Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
Marsh, H. W., Hau, K.-T., & Wen, Z. (2004). In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings. Structural Equation Modeling, 11(3), 320–341.
Jak to za vás Explonia dělá
Explonia spustí vaši CFA nebo SEM v prohlížeči a vrátí χ², CFI, TLI, RMSEA (s jeho 90% confidence intervalem) a SRMR v jedné fit tabulce s použitím výše uvedených cutoffů. Pokud jste použili robustní odhad, ukáže škálované indexy. Funkce „Article description" navrhne APA fit větu s vašimi čísly už na místě, kterou upravíte a ponecháte jako svou vlastní práci. Fit tabulku můžete exportovat do Wordu, R, SPSS/.sav, AMOS nebo LaTeXu.
Chcete mít fit tabulku a větu připravené k úpravě? Spusťte svůj model v Explonii a získejte reportování shody odpovídající stylu APA. Začněte zdarma →
Jak citovat tento článek
Pokud vám tento článek pomohl ve výzkumu, můžete jej citovat (APA 7):
Szymkowiak, A. (2026). Jak reportovat SEM fit indices: CFI, RMSEA, SRMR. Explonia. https://explonia.com/cs/blog/reporting-sem-fit-indices/
Last updated: červenec 2026
Proveďte celý výzkum na jednom místě
Navrhněte ho, sesbírejte data a spusťte skutečné CFA a SEM na vlastních datech — s návrhem odstavce APA, který můžete upravit. Začněte zdarma.
Začít zdarma