SEM-Fit-Indizes berichten: CFI, RMSEA, SRMR

Diese Seite ist eine Übersetzung des geprüften englischen Originals. Original ansehen (EN)
reporting SEM fit indicesAndrzej Szymkowiak · Zuletzt geprüft im Juli 2026
Ein Gutachter hat Sie gerade gebeten, Ihren Modell-Fit zu begründen. Hier steht genau, was Sie berichten müssen. Nachdem Sie ein structural equation model (SEM) oder eine confirmatory factor analysis (CFA) durchgeführt haben, lautet die erste Frage eines Gutachters: Passt das Modell zu den Daten? Diese Frage beantworten Sie mit fit indices. Diese Anleitung erklärt die wichtigsten Indizes, die Schwellenwerte, die Gutachter erwarten, und wie Sie sie im APA-Stil formulieren. Das Ziel ist eine saubere Tabelle und ein paar korrekte Sätze.
Warum Sie mehrere Indizes berichten
Der Modell-Fit ist nicht eine einzige Zahl. Jeder Index betrachtet den Fit aus einem leicht anderen Blickwinkel, daher berichten Sie einen kleinen Satz zusammen. Nur einen Index zu berichten — besonders den Chi-Quadrat-Test — reicht nicht aus. Ein verbreiteter, viel zitierter Satz ist: χ², CFI, TLI, RMSEA und SRMR (Hu & Bentler, 1999).
Der Chi-Quadrat-Test (und sein Problem)
Der χ²-Test prüft die Nullhypothese, dass die von Ihrem Modell implizierte Kovarianzmatrix der Kovarianzmatrix der Population entspricht. Ein nicht signifikantes χ² ist mit gutem Fit vereinbar, beweist aber das Modell nicht: Die Nullhypothese nicht zu verwerfen ist nicht dasselbe wie sie zu bestätigen. Das Problem: χ² reagiert sehr empfindlich auf die Stichprobengröße. Bei einer großen Stichprobe ist χ² fast immer signifikant, selbst für ein gutes Modell. Sie berichten es also der Vollständigkeit halber, aber Sie verwerfen ein Modell nicht allein wegen χ². Berichten Sie den Wert, die Freiheitsgrade und den p-Wert:
χ²(98) = 142.31, p = .002
Die inkrementellen Indizes: CFI und TLI
CFI (comparative fit index) und TLI (Tucker-Lewis index) vergleichen Ihr Modell mit einem Basismodell, in dem alle Variablen unabhängig sind. Höher ist besser. CFI ist auf den Bereich zwischen 0 und 1 begrenzt, während TLI nicht normiert ist — es kann gelegentlich 1 überschreiten oder unter 0 fallen.
- CFI ≥ .95 = guter Fit; ≥ .90 = akzeptabler Fit.
- TLI ≥ .95 = guter Fit; ≥ .90 = akzeptabler Fit.
Die absoluten Indizes: RMSEA und SRMR
RMSEA (root mean square error of approximation) und SRMR (standardized root mean square residual) messen, wie weit Ihr Modell von einem perfekten Fit entfernt ist. Niedriger ist besser.
- RMSEA ≤ .06 = guter Fit; ≤ .08 = akzeptabler Fit. Berichten Sie immer das 90%-Konfidenzintervall für RMSEA.
- SRMR ≤ .08 = guter Fit.
Die Schwellenwerte in einer Tabelle
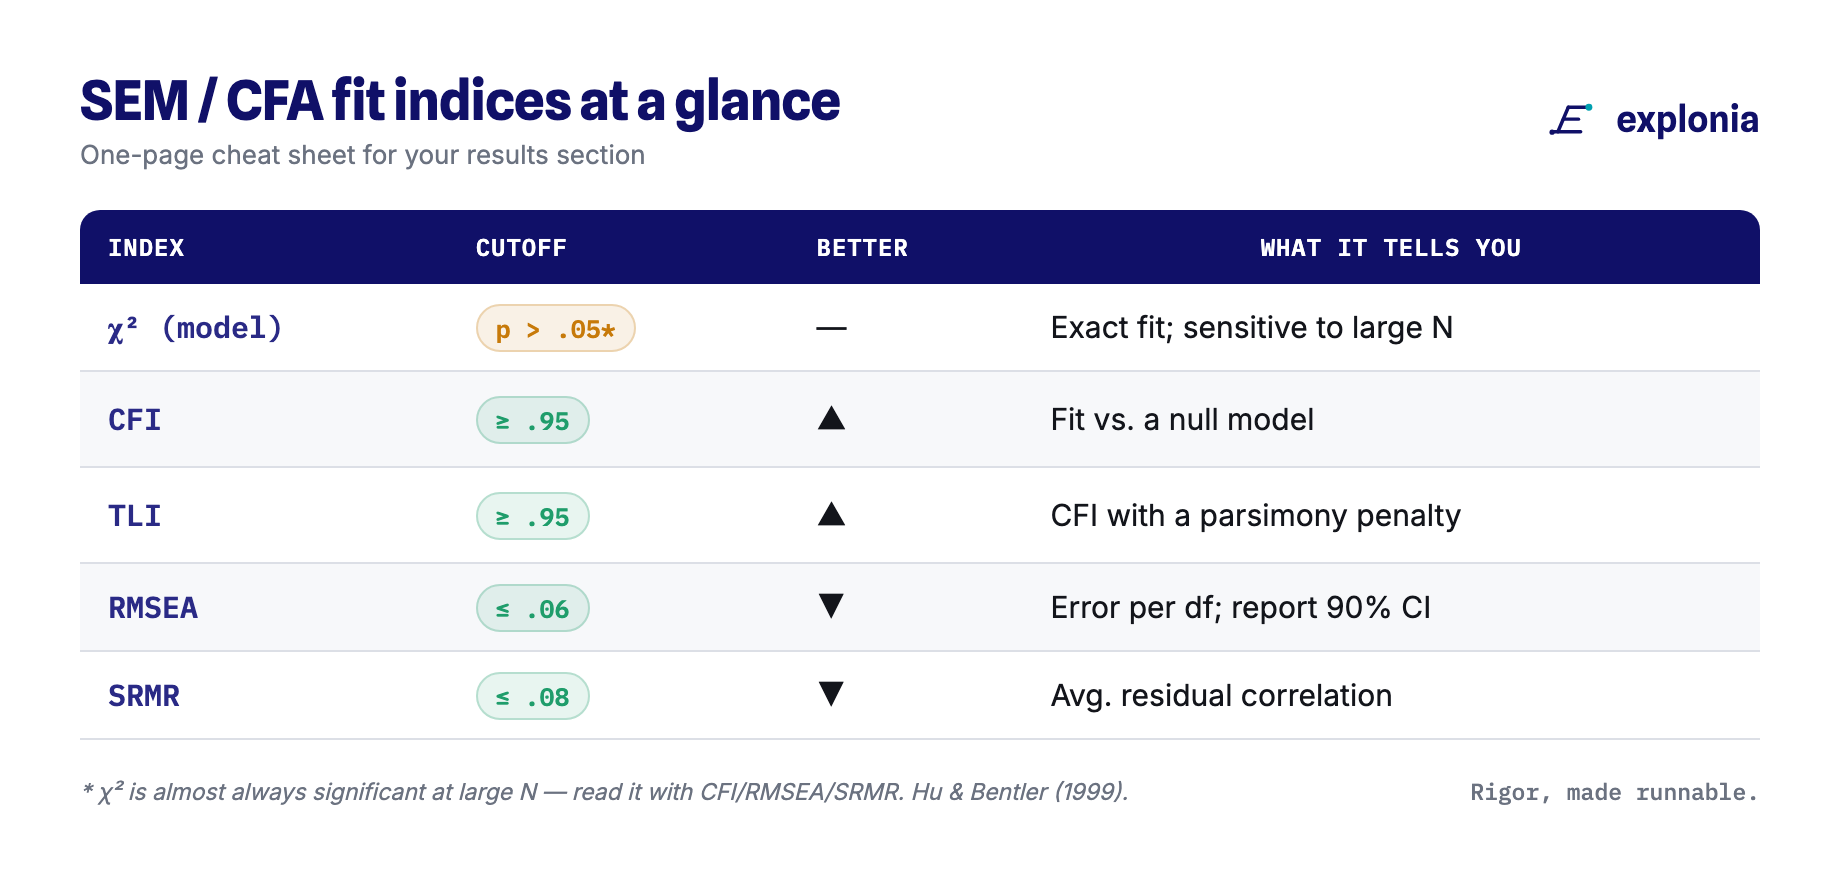
| Index | Guter Fit | Akzeptabler Fit | Hinweise |
|---|---|---|---|
| χ² | nicht signifikant | — | empfindlich gegenüber großem N; berichten, aber nicht überbewerten |
| CFI | ≥ .95 | ≥ .90 | höher ist besser |
| TLI | ≥ .95 | ≥ .90 | höher ist besser |
| RMSEA | ≤ .06 | ≤ .08 | 90% CI berichten |
| SRMR | ≤ .08 | — | niedriger ist besser |
Trennen Sie hier die Zuordnung: Die strengeren Schwellenwerte für „guten Fit" stammen von Hu und Bentler (1999), während der Schwellenwert von .90 für „akzeptablen" Fit auf eine frühere Arbeit zurückgeht — Bentler und Bonett (1980) schlugen ihn für NFI und TLI (damals NNFI genannt) vor, und er wurde später auf CFI übertragen (Bentler, 1990) — und RMSEA ≤ .08 spiegelt eine separate, frühere Konvention wider (Browne & Cudeck, 1993). Behandeln Sie sie als Richtlinien, nicht als harte Bestanden/Durchgefallen-Linien. Hu und Bentler (1999) empfehlen außerdem ein kombiniertes Kriterium, statt einen einzelnen Index allein zu lesen — zum Beispiel SRMR ≤ .08 zusammen mit CFI ≥ .95. Beurteilen Sie den Fit über den gesamten Satz von Indizes und berücksichtigen Sie Ihre Stichprobengröße und Modellkomplexität (wenn Sie noch in der Designphase sind, siehe Stichprobengröße vor der Datenerhebung für Hinweise zur Wahl eines angemessenen N). Die Schwellenwerte wurden unter bestimmten Simulationsbedingungen abgeleitet, übergeneralisieren Sie sie also nicht: Sie können sich bei kleinen Stichproben, komplexen Modellen oder anderen Schätzern anders verhalten, und ein Modell, das einen Wert knapp verfehlt, ist nicht automatisch "falsch" (Marsh, Hau, & Wen, 2004).
Formatierungsregeln im APA-Stil
- Berichten Sie χ² mit seinen Freiheitsgraden in Klammern und dem p-Wert: χ²(df) = Wert, p = …
- Verwenden Sie keine führende Null für Indizes, die 1 nicht überschreiten können: CFI = .97 (nicht 0.97). Dasselbe gilt für TLI, RMSEA, SRMR.
- Geben Sie das RMSEA-Konfidenzintervall in eckigen Klammern an: RMSEA = .038, 90% CI [.023, .051].
- Kursivieren Sie statistische Symbole, wo APA es erwartet (zum Beispiel p).
Ein durchgerechnetes Beispiel
Sie rechnen ein Strukturmodell mit N = 320. Die Ausgabe liefert χ²(98) = 142.31, p = .002, CFI = .97, TLI = .96, RMSEA = .038 mit einem 90% CI von [.023, .051] und SRMR = .041. Prüfen Sie jeden Wert gegen die Tabelle: CFI und TLI liegen über .95, RMSEA liegt unter .06 und SRMR liegt unter .08. Alle Indizes weisen auf guten Fit hin, obwohl χ² signifikant ist — was bei dieser Stichprobengröße zu erwarten ist. Ihr APA-Satz:
Das Strukturmodell zeigte einen guten Fit zu den Daten, χ²(98) = 142.31, p = .002, CFI = .97, TLI = .96, RMSEA = .038, 90% CI [.023, .051], SRMR = .041.
CFA-Fit vor SEM-Fit
Es ist gute Praxis, das Messmodell zu bestätigen, bevor Sie dem Strukturmodell vertrauen. In einem zweistufigen Ansatz rechnen Sie zuerst eine CFA, um zu prüfen, dass Ihre Items auf die richtigen Faktoren laden und dass der Fit gut ist, dann fügen Sie die strukturellen Pfade hinzu und rechnen das SEM. Wenn der CFA-Fit schlecht ist, stehen die strukturellen Ergebnisse auf wackeligem Grund, beheben Sie also zuerst das Messmodell. Berichten Sie beides: Der CFA-Fit zeigt, dass Ihre Konstrukte gut gemessen sind, und der SEM-Fit zeigt, dass das Pfadmodell hält. Dieselben Indizes und Schwellenwerte gelten für beide Schritte, weshalb ein einziges Fit-Tabellenformat durchgehend funktioniert. Für die vollständige Darstellung der Messseite siehe wie man CFA-Ergebnisse im APA-Stil berichtet, und prüfen Sie die Unterscheidbarkeit der Konstrukte mit HTMT vs Fornell-Larcker (Henseler, Ringle, & Sarstedt, 2015). Wenn Sie Ihre Modelle in R rechnen, siehe wie sich Explonia mit lavaan vergleicht für einen Vergleich des Workflows und des Ausgabeformats.
Häufige Fehler, die Sie vermeiden sollten
- Nur χ² berichten und ein gutes Modell verwerfen, weil χ² bei großem N signifikant ist.
- Einen Index isoliert lesen statt Hu und Bentlers kombiniertes Kriterium (z. B. SRMR ≤ .08 UND CFI ≥ .95).
- Das RMSEA-90%-Konfidenzintervall weglassen.
- Eine führende Null bei fit indices hinzufügen (schreiben Sie .97, nicht 0.97).
- Robuste (MLR) und nicht-robuste Indizes in derselben Tabelle mischen.
Ein Hinweis zur robusten Schätzung
Wenn Ihre Daten nicht normalverteilt sind und Sie robuste Maximum-Likelihood-Schätzung (MLR) verwendet haben, berichten Sie die skalierten (robusten) fit indices und das skalierte χ². Mischen Sie keine robusten und nicht-robusten Zahlen in derselben Tabelle. Geben Sie an, welchen Schätzer Sie verwendet haben, damit der Leser die Werte korrekt interpretieren kann.
Was, wenn der Fit nicht gut ist?
Wenn mehrere Indizes die Schwellenwerte verfehlen, löschen Sie nicht einfach Items, bis die Zahlen besser aussehen. Suchen Sie nach theoriebasierten Gründen: ein falsch spezifizierter Pfad, Items, die auf den falschen Faktor laden, oder ein Konstrukt, das zwei Dimensionen statt einer braucht. Modifikationsindizes können Änderungen vorschlagen, aber wenden Sie sie nur an, wenn sie theoretisch sinnvoll sind, und berichten Sie jede Änderung, die Sie vornehmen.
Häufig gestellte Fragen
Was ist ein guter RMSEA-Wert?
RMSEA ≤ .06 zeigt guten Fit an (Hu & Bentler, 1999); die Grenze von ≤ .08 für „akzeptablen" Fit stammt aus einer früheren Konvention (Browne & Cudeck, 1993). Berichten Sie immer das 90%-Konfidenzintervall, denn ein Punktschätzer allein kann Unsicherheit verbergen — ein breites Intervall, das über .08 reicht, ist schwächer als ein enges, das unter .06 bleibt.
Warum ist mein Chi-Quadrat signifikant?
χ² reagiert sehr empfindlich auf die Stichprobengröße. Bei großem N erzeugt selbst ein gut passendes Modell meist ein signifikantes χ². Deshalb berichten Sie χ² der Vollständigkeit halber, beurteilen den Fit aber anhand des vollständigen Satzes von Indizes (CFI, TLI, RMSEA, SRMR), nicht anhand von χ² allein.
Welche fit indices sollte ich berichten?
Berichten Sie χ² mit seinen Freiheitsgraden und dem p-Wert, dazu CFI, TLI, RMSEA (mit dem 90%-Konfidenzintervall) und SRMR. Dieser Satz deckt inkrementellen und absoluten Fit ab und ist das, was die meisten Gutachter erwarten (Hu & Bentler, 1999).
Berichte ich unterschiedliche Indizes für CFA und SEM?
Nein. Dieselben Indizes und Schwellenwerte gelten für beide. Bestätigen Sie zuerst den CFA-Fit (Messmodell), dann berichten Sie den SEM-Fit (Strukturmodell) im selben Tabellenformat.
Kann Explonia meine Fit-Tabelle erstellen?
Ja. Explonia liefert χ², CFI, TLI, RMSEA mit dem 90%-Konfidenzintervall und SRMR in einer Tabelle und entwirft einen APA-Fit-Satz mit Ihren Zahlen, den Sie anschließend bearbeiten.
References
Bentler, P. M. (1990). Comparative fit indexes in structural models. Psychological Bulletin, 107(2), 238–246. https://doi.org/10.1037/0033-2909.107.2.238
Bentler, P. M., & Bonett, D. G. (1980). Significance tests and goodness of fit in the analysis of covariance structures. Psychological Bulletin, 88(3), 588–606. https://doi.org/10.1037/0033-2909.88.3.588
Browne, M. W., & Cudeck, R. (1993). Alternative ways of assessing model fit. In K. A. Bollen & J. S. Long (Eds.), Testing structural equation models (pp. 136–162). Sage.
Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. https://doi.org/10.1007/s11747-014-0403-8
Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
Marsh, H. W., Hau, K.-T., & Wen, Z. (2004). In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings. Structural Equation Modeling, 11(3), 320–341.
Wie Explonia das für Sie erledigt
Explonia rechnet Ihre CFA oder Ihr SEM im Browser und liefert χ², CFI, TLI, RMSEA (mit dem 90%-Konfidenzintervall) und SRMR in einer Fit-Tabelle, unter Verwendung der obigen Schwellenwerte. Wenn Sie robuste Schätzung verwendet haben, zeigt es die skalierten Indizes. Die Funktion "Article description" entwirft einen APA-Fit-Satz mit Ihren bereits eingesetzten Zahlen, den Sie bearbeiten und als eigene Arbeit behalten. Sie können die Fit-Tabelle nach Word, R, SPSS/.sav, AMOS oder LaTeX exportieren.
Wollen Sie Ihre Fit-Tabelle und Ihren Satz bearbeitungsbereit haben? Rechnen Sie Ihr Modell in Explonia und erhalten Sie ein Fit-Reporting im APA-Stil. Kostenlos starten →
So zitieren Sie diesen Artikel
Wenn dieser Artikel Ihrer Forschung geholfen hat, können Sie ihn zitieren (APA 7):
Szymkowiak, A. (2026). SEM-Fit-Indizes berichten: CFI, RMSEA, SRMR. Explonia. https://explonia.com/de/blog/reporting-sem-fit-indices/
Last updated: Juli 2026
Führen Sie Ihre ganze Studie an einem Ort durch
Gestalten Sie sie, sammeln Sie die Daten und führen Sie echte CFA und SEM mit Ihren eigenen Daten durch — mit einem APA-Absatzentwurf, den Sie bearbeiten können. Kostenlos starten.
Kostenlos starten